Votre site bloque peut-être les robots d’IA sans que vous le sachiez
GPTBot, ClaudeBot, OAI-SearchBot, PerplexityBot : certains robots entraînent les modèles, d'autres alimentent la recherche des assistants. Comment vérifier votre robots.txt et décider quoi bloquer.
La réponse courte
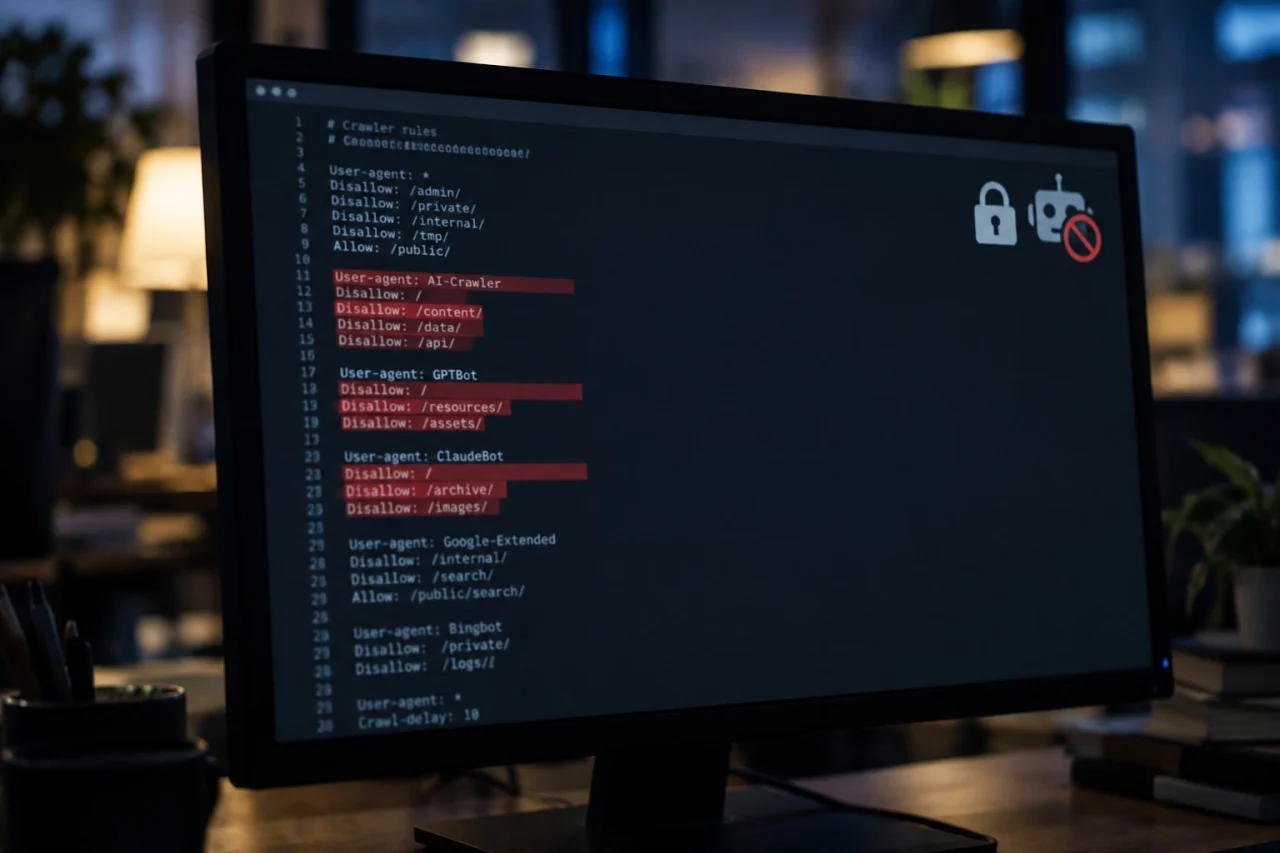
Tapez votre nom de domaine suivi de /robots.txt dans votre navigateur. Si vous y voyez OAI-SearchBot, Claude-SearchBot ou PerplexityBot suivis de Disallow: /, votre site est exclu de la recherche de ChatGPT, de Claude ou de Perplexity. Bloquer GPTBot, ClaudeBot, CCBot ou Google-Extended a un autre effet : vos contenus ne servent plus à entraîner les modèles. Ce sont deux décisions différentes, qui se prennent séparément.
De plus en plus de recherches passent par un assistant : l’internaute pose sa question, obtient une réponse rédigée, et quelques entreprises y sont citées avec un lien. Pour en faire partie, une condition passe avant toutes les autres : le robot de l’assistant doit pouvoir lire vos pages. C’est le point de départ de tout travail de visibilité dans les IA, et c’est aussi le plus souvent négligé.
Nous le constatons régulièrement en auditant des sites : des robots d’IA y sont bloqués sans que le dirigeant l’ait décidé, ni même su. Le blocage n’est pas toujours une erreur. Mais il doit être un choix.
Vérifier son robots.txt en deux minutes
Le fichier robots.txt se trouve toujours à la racine du site. Tapez votre-domaine.fr/robots.txt dans la barre d’adresse : vous obtenez un court fichier texte. Chaque bloc commence par une ligne User-agent, qui désigne un robot, suivie de règles Allow ou Disallow.
Si un robot apparaît avec Disallow: /, l’accès lui est refusé sur tout le site. Si aucun nom de la liste ci-dessous n’apparaît, et que le bloc général User-agent: * ne bloque pas tout, aucun blocage spécifique n’est en place dans ce fichier.
Les robots à connaître et ce qu’ils font
Chaque éditeur d’IA utilise plusieurs robots, avec des rôles bien distincts. Ces rôles sont décrits par les éditeurs eux-mêmes dans leur documentation publique, que nous avons relue au 3 novembre 2026.
| Robot | Éditeur | Rôle |
|---|---|---|
| GPTBot | OpenAI | Collecte des contenus susceptibles de servir à l’entraînement des modèles |
| OAI-SearchBot | OpenAI | Indexe les sites pour les faire apparaître dans la recherche de ChatGPT |
| ChatGPT-User | OpenAI | Consulte une page à la demande d’un utilisateur de ChatGPT |
| ClaudeBot | Anthropic | Collecte des contenus susceptibles de servir à l’entraînement des modèles |
| Claude-SearchBot | Anthropic | Explore le web pour améliorer les résultats de recherche de Claude |
| Claude-User | Anthropic | Consulte une page quand un utilisateur de Claude pose une question qui le nécessite |
| PerplexityBot | Perplexity | Indexe les sites pour les citer et les lier dans les résultats de Perplexity ; pas d’entraînement selon l’éditeur |
| Google-Extended | Pas un robot distinct mais une consigne : elle indique si les contenus déjà explorés par Google peuvent servir aux modèles Gemini (entraînement et ancrage des réponses) | |
| CCBot | Common Crawl | Alimente une archive ouverte du web, très largement réutilisée, notamment pour entraîner des modèles |
Trois familles, trois effets différents
L’entraînement. GPTBot, ClaudeBot et CCBot collectent des pages qui peuvent nourrir les futurs modèles. Google-Extended joue le même rôle de consigne pour Gemini. Les bloquer ne vous retire pas des réponses de recherche des assistants ; cela indique seulement que vos contenus ne doivent pas servir à l’entraînement. Google précise aussi que Google-Extended n’a aucun effet sur votre présence ni sur votre classement dans la recherche Google.
La recherche. OAI-SearchBot, Claude-SearchBot et PerplexityBot constituent l’index dans lequel les assistants puisent les sites qu’ils citent. Ce sont eux qu’il faut laisser passer si vous voulez apparaître dans les réponses. OpenAI l’écrit clairement : un site qui bloque OAI-SearchBot n’apparaît pas dans les résultats de recherche de ChatGPT.
La consultation à la demande. ChatGPT-User, Claude-User et Perplexity-User visitent une page parce qu’un utilisateur vient de poser une question, pas pour explorer le web. Leur rapport au robots.txt diffère selon l’éditeur : Anthropic indique que Claude-User le respecte, tandis qu’OpenAI et Perplexity expliquent que ces règles peuvent ne pas s’appliquer à des visites déclenchées par un utilisateur.
Refuser l’entraînement et rester visible dans les réponses des assistants n’est pas contradictoire : ce sont deux réglages différents.
D’où vient le blocage quand personne ne l’a demandé
Trois origines reviennent dans nos audits. Une extension de sécurité ou de référencement peut écrire ces règles dans le robots.txt, parfois sans l’annoncer clairement. Un prestataire précédent a pu tout bloquer par précaution, à une époque où la distinction entre entraînement et recherche n’existait pas encore chez la plupart des éditeurs. Enfin, le blocage peut ne pas se trouver du tout dans le robots.txt : certains pare-feu, CDN et protections anti-robots refusent ces visiteurs au niveau du serveur.
Ce dernier cas est le plus trompeur. Le robots.txt semble parfait, mais le robot reçoit une erreur ou une page de vérification. Seule la lecture des journaux du serveur, ou des réglages du pare-feu, permet de le voir. C’est un point que nous contrôlons systématiquement lors d’un travail de SEO technique, au même titre que l’accès de Googlebot.
Où en est votre site face aux assistants ?
Notre diagnostic de visibilité IA prend deux minutes et passe en revue l’accès des robots, les données structurées et la mesure des visites venues des assistants.
Faut-il les laisser passer ?
La réponse dépend de ce que représente votre contenu. Pour un média, un éditeur ou toute entreprise dont le contenu est le produit, bloquer les robots d’entraînement est une position défendable : c’est refuser qu’un travail éditorial nourrisse gratuitement des modèles commerciaux.
Pour la plupart des entreprises que nous accompagnons, le site est un support commercial. Son rôle est d’être lu, repris et cité. Bloquer les robots de recherche revient alors à demander à un prescripteur de ne jamais parler de vous. Notre recommandation par défaut est donc simple : laisser passer les robots de recherche et de consultation, et décider des robots d’entraînement en connaissance de cause.
Un exemple de réglage sélectif
Pour refuser l’entraînement tout en restant visible dans la recherche des assistants, le robots.txt contient un bloc par robot d’entraînement, par exemple User-agent: GPTBot suivi de Disallow: /, puis la même chose pour ClaudeBot, CCBot et Google-Extended. Les robots de recherche ne sont pas mentionnés, ou le sont avec Allow: /. OpenAI précise qu’une modification est prise en compte par ses systèmes de recherche en environ vingt-quatre heures.
Les noms de ces robots évoluent : de nouveaux apparaissent, d’autres changent de rôle. Un réglage fait une fois pour toutes vieillit vite, et c’est pourquoi nous relisons la documentation des éditeurs à chaque intervention.
Débloquer ne suffit pas
Un robot autorisé à lire une page qui ne répond à aucune question précise ne citera pas davantage votre entreprise. L’accès est une condition d’entrée, pas un levier de visibilité. Personne ne peut d’ailleurs garantir qu’un assistant vous citera : ces systèmes changent sans prévenir. En revanche, trois chantiers améliorent nettement vos chances.
- Des contenus qui répondent. La réponse dès les premières lignes, puis le détail. C’est le format que les assistants reprennent le plus volontiers, et celui de cet article.
- Des données structurées. Un balisage propre dit à une machine, sans qu’elle ait à deviner, ce que vous vendez, où vous êtes et à qui vous vous adressez.
- La mesure. Les outils d’analyse d’audience distinguent les visites arrivées depuis ChatGPT, Claude ou Perplexity. Un segment dédié suffit pour relier cette visibilité à des demandes concrètes.
Commencez par le plus simple : ouvrez votre robots.txt aujourd’hui. Si des robots de recherche y sont bloqués, demandez-vous si c’était un choix. Le reste du travail ressemble beaucoup au référencement classique, avec une exigence supplémentaire sur la clarté des réponses.
Passionné par le numérique depuis toujours, j'ai créé TEVENNEC DIGITAL en 2015 en partant d'une volonté : adapter le web aux organisations. Ce leit motiv est toujours actuel, et je recherche sans cesse à améliorer nos processus métier, afin d'apporter le meilleur du digital à mes clients en continu. Si nous ne proposions que des sites vitrines et du SEO au début, avec Jeanne, nous proposons désormais un panel d'expertise complet, afin d'accompagner petites et grandes entreprises dans leurs défis numériques.
Où en est votre référencement ?
Le diagnostic SEO passe votre site en revue en deux minutes : technique, contenus, visibilité locale et présence dans les réponses des IA.